从目标到操作:数据配比、筛选与合成
中文版本由 ChatGPT 翻译,请参考英文版本。
语言模型的训练数据设计 · 三篇系列之三
什么时候值得优化,什么是好数据,以及如何改变数据。
加速与终点改善 · 什么是好的训练数据? · 从目标到操作
假设我们希望语言模型在某个目标上表现得更好——它可以是一个领域、一项任务,或一组能力——而我们能够改变模型使用的训练数据。那么,应该作出哪些改变?
一个目标,三种操作
一种直接的表达是:比较不同的训练分布 $q$,看各自在其上训练得到的模型 $\theta^*(q)$ 在目标上表现如何。令 $\mathcal Q$ 表示我们可以使用的训练分布集合,就得到一个双层优化目标:
\[\min_{q\in\mathcal Q} \mathcal L_{\mathrm{target}}\!\left(\theta^*(q)\right) \quad\text{s.t.}\quad \theta^*(q)\in\arg\min_\theta \mathbb E_{x\sim q}[\ell(x;\theta)].\]内层问题在 $q$ 上训练模型。外层问题选择这个分布,使训练后的模型在目标上表现得更好。
上一篇讨论了为什么要采用这个视角。这里转向“怎么做”:我们可以怎样改变训练数据,又如何找到有助于实现目标的改变? 前者关乎数据操作方式(operator),后者关乎求解算法(solver)。
三种常见的操作是:调整不同领域数据的比例,即配比(mixture);从现有数据池中选择样本或 token,即筛选(selection);以及生成新的训练样本,即合成(synthesis)。
| 操作 | 决策变量 | 能改变什么 | 边界在哪里 |
|---|---|---|---|
| 配比 | 领域比例 | 预先定义的各组数据获得多少训练机会 | 无法区分同一组内的样本 |
| 筛选 | 样本或 token 权重 | 现有数据池中哪些内容参与训练、参与多少 | 无法创造缺失的数据模式 |
| 合成 | 生成器、提示词或任务描述 | 有哪些样本可用于训练 | 不保证生成的数据有用或正确 |
每种操作都对应不同的可行分布集合 $\mathcal Q$。配比与筛选改变的是现有数据的使用方式。如果有用的行为已经存在,只是较少出现,重新分配训练机会可能有帮助。如果所需训练材料根本不存在,就需要采集或生成。合成让我们能够改变可用样本本身,使训练分布的设计不再局限于重新分配已有数据。
选定操作方式后,我们就有了一组需要决定的变量:领域比例、token 掩码,或生成相关的选择。但对于给定的操作,仍然需要优化这些变量。最直接的做法是:提出一个配比,训练一个语言模型,在目标上评价,然后换一个配比继续尝试,直到计算预算或耐心耗尽。对筛选来说,逐一尝试所有可能的子集就更不现实了。能否在不为每个候选方案从头训练模型的情况下,优化这些数据决策?
从双层目标到数据分配的更新
本节解释惩罚重构如何得到数据分配的更新。如果你更关心更新规则的直观含义,可以跳到后面的两个小节:TANDEM:哪些领域值得更多训练机会?和 BLADE:哪些 token 值得训练预算?。它们分别说明更新规则如何调整领域权重、如何选择 token。
先考虑配比与筛选:决策是在现有数据之间分配训练机会。用 $w$ 表示分配变量,$\mathcal W$ 表示其可行集合。对于配比,$w_k$ 是领域 $k$ 的采样比例;对于筛选,$w_p$ 是候选项 $p$ 的选择权重。两者的维度和约束不同,但都能确定一个训练分布 $q_w$。
记 $\mathcal L_{\mathrm{train}}(\theta;w)=\mathbb E_{x\sim q_w}[\ell(x;\theta)]$,就可以用 $w$ 来表达同一个双层目标。我们用 $\theta^*(w)$ 简写在 $q_w$ 上训练得到的模型。合成需要另一种参数化,后面再讨论。
我们通过惩罚重构,把相互耦合的双层问题转化为单层优化问题。令 $V(w)=\min_\theta\mathcal L_{\mathrm{train}}(\theta;w)$ 表示分配方案 $w$ 下能够达到的最小训练 loss。将实际训练 loss 超出这个最小值的部分作为惩罚项:
\[H_\lambda(w,\theta) =\mathcal L_{\mathrm{target}}(\theta) +\lambda\left[ \mathcal L_{\mathrm{train}}(\theta;w)-V(w) \right], \qquad\lambda>0.\]目标项鼓励模型降低目标 loss;惩罚项则要求模型在当前配比或筛选方案下,也接近训练 loss 的最小值,即近似满足内层训练约束。这个构造引入了两种模型角色:代理模型(proxy)通过训练来近似 $V(w)$ 中的最小值;参考模型(reference)则优化目标 loss 与加权训练 loss 之和。它们各自理想的优化目标是:
\[\begin{aligned} &\theta_{\mathrm{proxy}}^*(w) \in\arg\min_\theta\mathcal L_{\mathrm{train}}(\theta;w),\\ &\theta_{\mathrm{ref}}^*(w) \in\arg\min_\theta\left[ \mathcal L_{\mathrm{target}}(\theta) +\lambda\mathcal L_{\mathrm{train}}(\theta;w) \right]. \end{aligned}\]算法交替更新两个模型的参数与数据分配变量,并协调它们的更新过程。代理模型参数 $\theta_{\mathrm{proxy}}$ 通过梯度下降降低训练 loss;参考模型参数 $\theta_{\mathrm{ref}}$ 则针对目标 loss 与加权训练 loss 之和更新。两个模型都通过有限步更新来近似上面的最小化问题。
更新数据分配时,我们固定 $\theta_{\mathrm{proxy}}$ 和 $\theta_{\mathrm{ref}}$,用代理模型近似内层最小值,再对两个模型的训练 loss 之差关于 $w$ 求导:
\[\begin{aligned} &\partial_w\left\{\lambda\left[ \mathcal L_{\mathrm{train}}(\theta_{\mathrm{ref}};w) -\mathcal L_{\mathrm{train}}(\theta_{\mathrm{proxy}};w) \right]\right\}\\ &=\lambda\left[ \partial_w\mathcal L_{\mathrm{train}}(\theta_{\mathrm{ref}};w) -\partial_w\mathcal L_{\mathrm{train}}(\theta_{\mathrm{proxy}};w) \right]. \end{aligned}\]在后面两个小节给出的配比与筛选的具体形式中,训练 loss 与 $w$ 是线性关系。因此,数据分配的更新可以归结为下面的 loss 差:
\[s_i= \mathcal L_{\mathrm{train}}^i(\theta_{\mathrm{proxy}}) -\mathcal L_{\mathrm{train}}^i(\theta_{\mathrm{ref}}).\]对于配比,$i$ 索引领域;对于筛选,$i$ 索引 token。数据分配的梯度估计与 $-s_i$ 成正比,因此在操作约束允许的范围内,梯度下降会倾向于给 $s_i$ 较大的领域或 token 更多训练机会。
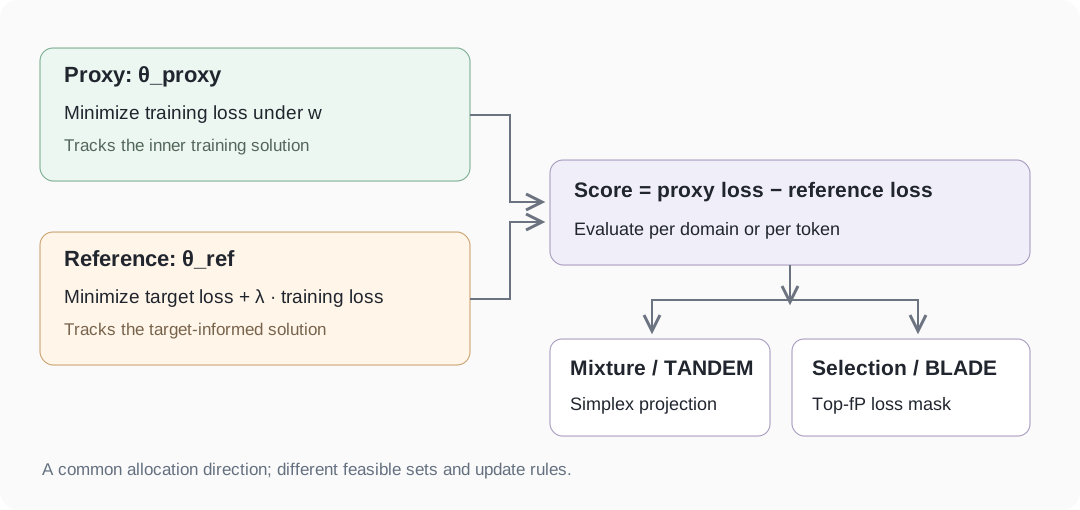
配比与筛选共享的惩罚法求解过程:两个相互耦合的模型提供基于 loss 差的更新信号;操作方式的约束决定这个信号最终如何变成数据分配规则。图中保留英文标注。
TANDEM:哪些领域值得更多训练机会?
假设我们可以调整模型接触 $K$ 个领域中每个领域的频率。这里,$w_k$ 是采样领域 $k$ 的概率,$\mathcal L_{\mathrm{train}}^k(\theta)$ 是模型在该领域上的期望训练 loss。前面的双层目标在这里具体化为:
| 组成部分 | TANDEM |
|---|---|
| 目标 loss | 各领域留出数据 loss 的加权平均。目标权重 $\widehat w_k$ 决定每个领域对评价的贡献,通常取 $\widehat w_k=1/K$。优化训练比例 $w$ 时,这些目标权重保持不变。 |
| 训练 loss | $\mathcal L_{\mathrm{train}}(\theta;w)=\sum_{k=1}^K w_k\mathcal L_{\mathrm{train}}^k(\theta)$。 |
| 可行的数据分配 | 概率单纯形 $\mathcal W_{\mathrm{mix}}$ 上的领域比例:$w_k\geq0$,且 $\sum_k w_k=1$。 |
这里的训练 loss 展示了前面共同求解过程中用到的线性关系:每个领域权重乘以对应的领域 loss。因此,对 $w_k$ 求导就得到 $\mathcal L_{\mathrm{train}}^k(\theta)$。这也解释了为什么两个模型的训练 loss 导数之差,会变成参考模型与代理模型的领域 loss 之差,给出数据分配的梯度估计 $-\lambda s_k$。投影梯度更新将它转化为新的配比:
\[w^{(t+1)} =\Pi_{\mathcal W_{\mathrm{mix}}} \left(w^{(t)}+\eta_w\lambda s^{(t)}\right).\]在领域层面,较大的正值 $s_k$ 意味着:引入目标信息后,模型在领域 $k$ 上的预测有所改善,即参考模型的领域 loss 低于只使用训练数据的代理模型。更新会推动这些领域的训练比例上升。投影操作保证概率非负且加和为一。随后,我们用学到的配比从头训练最终模型。
实践中,TANDEM 通过同步两个模型来控制它们之间的差距、稳定优化,并通过更新调度减少搜索成本。论文给出了完整流程,以及在所述假设下的一阶平稳性保证;参见 TANDEM 的第 2.2 节与附录 A。
看一个具体结果:在数据受限的 SlimPajama 实验中,我们从 300M-token 候选语料训练一个 160M 参数模型,较小领域的数据会被反复采样。在相同的最终训练流程下,TANDEM 学到的配比把平均困惑度从 Uniform 的 31.53 降到 28.07。这里的平均困惑度,是各领域留出数据 loss 的均值取指数。
最初让我意外的是,在数据充足、单遍训练的预训练中,能够获得的收益很小:TANDEM 的平均困惑度为 25.43,Uniform 为 25.74。在这个实验中,Uniform 训练和目标评价都给每个领域 $1/K$ 的权重,各领域内的数据也来自相同的底层分布,因此两个总体目标一致。充足的数据允许训练不必反复使用同一样本,观测到的训练—验证差距也接近零。后来,第一篇讨论的工作帮助我们理解了这种反差:在这个已经匹配的场景中,几乎没有分布错配可供重新加权来纠正。求解算法有效,但任务本身留给终点改善的空间有限。
BLADE:哪些 token 值得训练预算?
以领域为单位调整数据,粒度还是较粗。有用和无用的内容可能出现在同一篇文档中,甚至同一条推理轨迹里。因此,我们把分配决策细化到单个 token。这里,$w_p$ 表示候选 token $p$ 是否参与训练:一表示保留,零表示屏蔽其训练 loss。$\mathcal L_{\mathrm{train}}^p(\theta)$ 是 token 位置 $p$ 上的预测 loss。对于含有 $P$ 个候选 token 的数据池,我们保留比例 $f$。前面的双层目标在这里具体化为:
| 组成部分 | BLADE |
|---|---|
| 目标 loss | 目标验证数据上的预测 loss,$\mathcal L_{\mathrm{target}}(\theta)$。 |
| 训练 loss | 保留 token 位置上的平均 loss:$\mathcal L_{\mathrm{train}}(\theta;w)=\frac{1}{fP}\sum_{p=1}^P w_p\mathcal L_{\mathrm{train}}^p(\theta)$。 |
| 可行的数据分配 | token 掩码,满足 $w_p\in\lbrace 0,1\rbrace$,且 $\sum_p w_p=fP$。 |
这里的训练 loss 与 $w$ 也有相同的线性关系,因此共同求解过程得到 token 层面的 loss 差更新,数据分配的梯度估计为 $-\lambda s_p/(fP)$。 为了优化二元掩码,我们把 $w_p\in\lbrace 0,1\rbrace$ 放松为 $w_p\in[0,1]$,同时保持预算不变。得到的可行集合是一个带分量上界的单纯形(capped simplex)。
在 TANDEM 中,领域比例是加和为一的连续概率,因此我们用投影梯度下降,让每次更新都留在单纯形内。BLADE 则要求对每个 token 作出保留或丢弃的决定。暂时允许 token 权重取小数,是为了用连续优化处理这个离散问题。而 Frank–Wolfe 在这里恰好给出了一个很简洁的结果:采用步长为 1 的贪心更新时,更新会直接落到二元掩码上,也就是选择 loss 差最大的 $fP$ 个 token,无需额外舍入:
\[w_p =\mathbf 1\left\{p\in\operatorname{Top}_{fP}(s)\right\}.\]token 层面的 loss 差,比较的是只用训练数据的代理模型与引入目标信息的参考模型,在同一 token 上的预测表现。这种差异为判断哪些 token 可能帮助模型对齐目标提供了信号。为了让这个准则适用于大规模语料,BLADE 在候选批次内执行选择,从而实现在线 token 筛选,无需提前对整个语料评分并保存所有分数。
我们在一个 5B-token 的 OpenWebMath 数据池上,对 13B 语言模型进行持续预训练,以评价 token 筛选的效果。在九个数学相关基准测试 上,BLADE 的平均准确率为 54.4%,RHO-1 为 52.5%,全量数据持续预训练为 43.7%。BLADE 和 RHO-1 都保留 3B 个计入训练 loss 的 token,全量训练则使用全部 5B tokens。
BLADE 把基于影响函数的筛选方法所依赖的双层优化基础,与 RHO 类方法中计算高效的 loss 差准则联系起来,并引入与学习模型同步的动态参考模型。惩罚重构通过一阶模型更新和 loss 计算建立这种联系,不需要经典影响函数(influence functions)涉及的逆 Hessian 计算。参考模型定期用代理模型的参数重新初始化,再利用目标信息更新,使比较始终与当前学习模型保持联系,而不是依赖固定的预训练参考模型。方法之间的关系见第 2.3 节。在附录 A给定的假设和参数选择下,论文分析的全坐标更新流程也具有一阶平稳性保证。
TANDEM 和 BLADE 都通过代理模型与参考模型的比较,调整不同数据获得的训练机会。在各自约束下,同一个 loss 差信号分别用于更新领域比例和选择 Top-$k$ token。loss 差更新由目标、代理模型和参考模型的学习状态共同决定。这些状态反映了学习过程,以及训练样本共同作用的结果,包括它们的学习信号如何重叠、如何互补。这也具体体现了第二篇的视角:筛选准则通过学习模型和目标评价数据,而不是为每个领域或 token 赋予一个固有的质量分数。
合成:当重新分配还不够时
数据配比与筛选都假设,有用的训练材料已经存在于数据池的某个地方。如果不存在呢?无论怎么筛选,也无法从池中找出本来就没有的工具使用示例、失败恢复模式或推理策略。合成让样本本身也成为决策的一部分。
与配比和筛选一样,合成的效果也由模型在生成数据上训练后的目标表现来评价。分布层面的目标没有改变,改变的是参数化方式。令 $\psi$ 控制生成器、提示词或任务描述,并由此确定训练分布 $q_\psi$。用 $\theta^*(\psi)$ 表示在 $q_\psi$ 上训练得到的模型,问题就变成
\[\min_{\psi\in\Psi} \mathcal L_{\mathrm{target}}\!\left(\theta^*(\psi)\right) \quad\text{s.t.}\quad \theta^*(\psi)\in\arg\min_\theta \mathbb E_{x\sim q_\psi}[\ell(x;\theta)].\]允许使用的生成参数集合 $\Psi$ 与生成预算,共同定义了可得到的分布集合 $\mathcal Q_{\mathrm{synth}}={q_\psi:\psi\in\Psi}$。生成既可以引入缺失的数据模式,也可以在已有模式中补充更多样本。
对于配比与筛选,训练 loss 与分配权重之间的线性关系,带来了简洁的 loss 差更新。当决策改变的是生成样本本身时,能否得到同样简洁高效的更新,是把这套求解方法扩展到合成时尚待解决的问题。
配比、筛选与合成也可以在一个由目标驱动的数据流程中共同使用。我在实践中采用过这样的循环:
目标任务中的失败 → 识别缺少的训练材料 → 生成候选数据 → 筛选或验证 → 训练模型 → 在目标上评价。
在这个循环中,LLM 负责生成候选数据,再由目标引导的筛选决定保留什么,从而绕开了直接求解双层生成问题的需要。
目标、差距与操作方式
这三篇文章依次讨论了:我们获得的是哪一种提升,什么让一个训练分布有价值,以及实践中可以如何改变它。
面对一个新的数据问题,首先要问的是:我们关心什么目标?普通训练在哪些地方还做得不够?现有数据中是否包含能够提供帮助的材料?这些答案会引导我们选择操作方式,并决定如何优化。
也可以用三句话概括:
目标决定优化什么。
差距决定改善空间。
操作方式决定哪些改善是可实现的。
把这三者放在一起明确下来,才是训练数据设计的起点。